
‘AI 때’ 안묻은 자료 노린다…AI의 ‘헌책 헌팅’ 까닭
인공지능(AI) 생성 이미지
이 논문은 AI 기업들이 책 매집에 집중하는 이유를 잘 보여준다. 주재걸 카이스트 AI대학원 교수는 “인터넷상에 AI가 만든 콘텐트가 늘어나는 상황에서, 과거에 사람이 AI 도움 없이 작성한 책은 인간의 사고와 노력이 온전히 담긴 자료는 최근 들어 더 중요성이 부각된다”고 설명했다. 주 교수는 “이미 인터넷에 있는 자료는 AI가 모두 학습을 끝냈다고 봐도 된다”고 덧붙였다.
올 1월 AI 기업 앤트로픽이 법원에 제출한 서류에도 AI 학습에 책이 중요하다는 경영진의 인식이 드러난다. 앤트로픽은 책을 대량 매입해 AI 학습시켰다는 이유로 출판사 등으로부터 소송을 당해 재판을 받았다. 제출한 서류에 따르면, 공동 창업자 중 한 명은 책을 활용해 AI를 훈련시키면 AI가 “저질 인터넷 어투”를 모방하는 대신 “잘 쓰는 법”을 배울 수 있을 것이라고 했다.
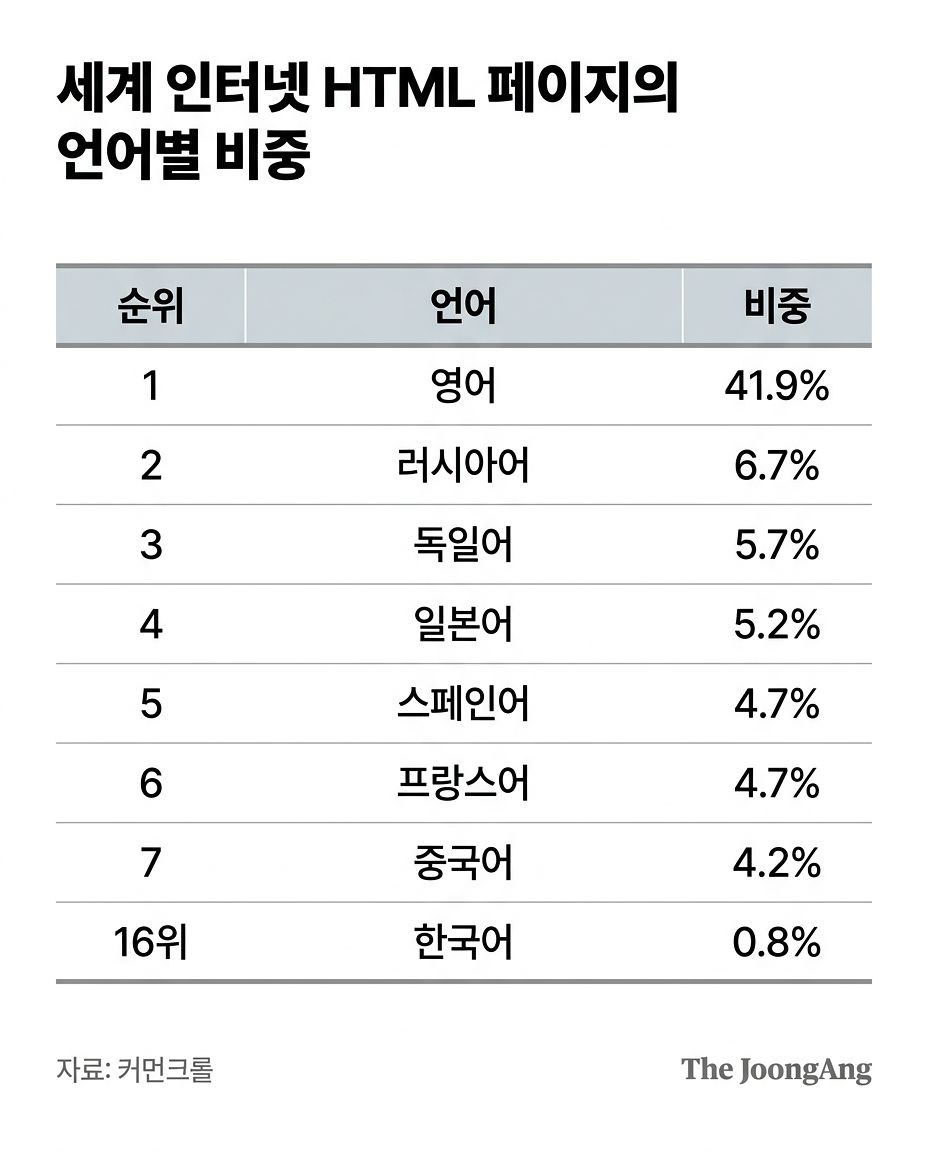
세계 인터넷 HTML 페이지의 언어별 비중
인터넷의 웹페이지를 대규모로 수집해 무료로 공개하는 비영리 기관 ‘커먼 크롤’(Common Crawl)에 따르면, 전 세계 웹페이지 중에서 한국어로 된 페이지 비중은 0.8%밖에 안 된다. 인터넷 공간이 AI 콘텐트로 오염되고 있는 상황인데, 학습할 한국어 페이지 자체도 얼마 안 되기 때문에 책이 필요한 것이다. 스페인에선 소수어인 카탈루냐어로 된 논픽션 중고서적이 대량 판매되기도 했다.
샘 알트먼 OpenAI CEO, 다리오 아모데이 앤트로픽 CEO. [AFP=연합뉴스]
서용석 교수는 AI 기업들이 세계 곳곳에서 헌책을 사들이는 현상을 ‘모델 제국주의’라고 지적했다. 제국주의 시대 식민지 무역은 식민지에서 원료를 싸게 가져가 본국에서 가공한 뒤 완제품을 식민지에 비싸게 파는 구조였다. 지금 AI 시대는 한국 사회가 지난 100여년간 축적한 지식이 헌책이라는 원료의 형태로 헐값에 반출되고, 해외 기업의 AI 모델로 가공된 뒤 AI 서비스라는 완제품으로 돌아와 우리가 돈을 쓰게 한다는 점에서 제국주의 시대와 비슷하다는 게 서 교수 설명이다.
서 교수는 “한국이 지식의 생산국에서 지식 원료의 공급국이자, AI 서비스의 소비국 위치로 바뀌는 셈”이라고 지적했다.
윤성민([email protected])