
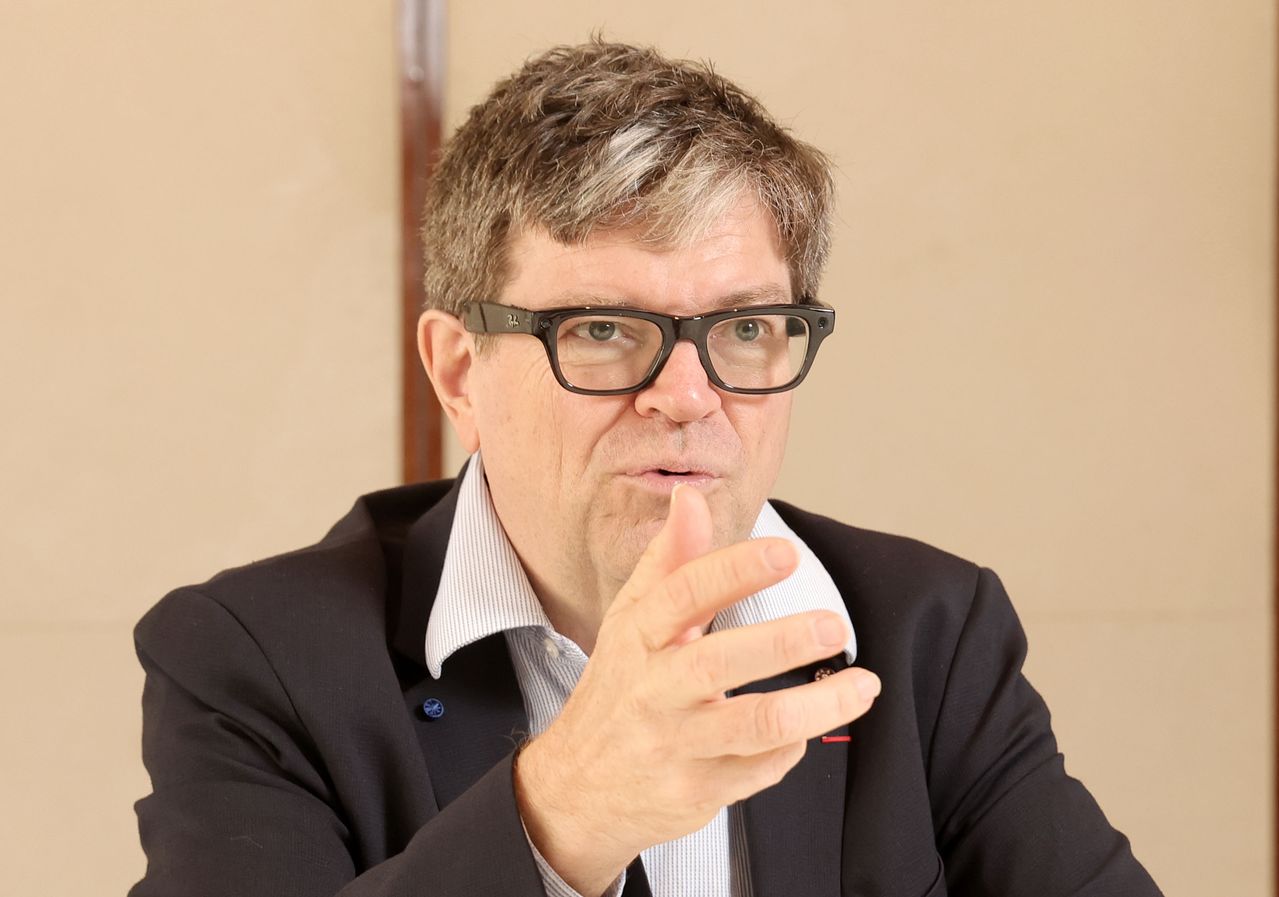
얀 르쿤 AMI랩스 회장이 12일 서울 소공동 웨스틴조선호텔에서 중앙일보와 인터뷰하고 있다. 강정현 기자
얀 르쿤 AMI랩스 회장은 12일 서울 중구 소공로 웨스틴조선서울에서 가진 중앙일보와 인터뷰에서 이렇게 말했다. 최근 불거진 ‘AI 종말론’에 대해 그는 “(현재 주류인) 대규모언어모델(LLM)은 자신이 한 행동이 어떤 결과로 이어질지 예측할 수 없고, 그 결과가 인간에게 어떤 영향을 미치는지도 모른다”며 “인간의 경우 열 살짜리 아이도 알 수 있는 것”이라고 설명했다.
뉴욕대 교수인 르쿤 회장은 AI 기반 기술인 딥러닝 연구로 요슈아 벤지오 몬트리올대 교수, 제프리 힌턴 토론토대 교수와 함께 2018년 ‘컴퓨터 과학계 노벨상’으로 불리는 튜링상을 받았다. 메타 수석AI과학자로 일하던 그는 올해 1월 메타를 떠나 AMI랩스를 세웠다. 언어 환경 중심의 LLM과 다른 실제 환경의 움직임을 학습해 다음 행동을 예측하는 AI모델(월드모델)을 개발하는 게 목표다. 르쿤 회장은 “매년 미국에선 잔디깎이 사고로 100명이 숨지는데 AI는 매일 10억명이 써도 심각한 사고가 드물다”며 “AI가 잔디깎이보다 훨씬 안전하다”고 강조했다. 르쿤 회장은 이날 같은 장소에서 열린 ‘산업 AI 글로벌 협력 간담회’에 참석하기 위해 방한했다. 다음은 일문일답.
Q : 최근 한국에선 AI 해킹 사고가 연달아 나왔다.
A : “기본적으로 기업이 부주의한 탓이다. AI에이전트(비서)를 배포한 개발사의 보안 경험이 부족했고, AI를 가둬 두는 격리환경(샌드박스)에는 허점이 있었다. AI를 통제할 수 없어서 발생한 사고가 아니다. 사이버 보안 문제로 봐야 한다.”
A : “어려운 문제가 아니다. ‘엔지니어링’(공학)으로 해결하면 된다. AI에 명령을 내린 순간 안전장치(가드레일)가 작동하는 ‘목표 지향형 AI’(Objective Driven AI)로 설계해야 한다. 인간이 설정한 목표 외엔 돌발 행동을 할 수 없는 AI를 뜻한다. 식칼을 든 로봇에 ‘주변에 사람이 있으면 팔을 휘두르지 말 것’이라는 규칙을 설정하는 식이다.”
Q : 지금 나온 AI에도 적용할 수 있나.
A : “LLM의 경우 이용자의 개별 명령에 대응하는 규칙을 일일이 ‘미세조정’(파인튜닝)하기 어렵다. 그러니까 AI의 ‘일탈’이 잦은 것이다. 샘 올트먼 오픈AI CEO가 속도 조절을 강조하며 차기 모델을 출시하지 않는 이유도 여기에 있다. 충분히 미세조정되지 않았다고 느껴서다.”
Q : 벤지오·힌턴도 AI 종말론을 주장하는데.
A : “둘 다 AI가 인간을 뛰어넘을 것을 가정하고 말하는데, 동의하지 않는다. 지금의 AI는 인간이 쌓은 지식을 취합하고, 이를 되풀이하는 것에 불과하다. 자가 검증이 가능한 수학, 코딩 등 제한적인 영역을 제외하면 그다지 영리하지 않다.”
Q : 그럼 AI는 어떤 점이 위험한가.
A : “과도한 독점이 문제다. 현재 대다수 사람이 AI를 거쳐 정보를 습득하는데, 그 시스템을 소수 기업이 독점하면 전 세계의 가치·언어 다양성은 사라진다. 정보가 오가는 경로를 틀어 쥔 다리오 아모데이(앤트로픽 CEO)가 “AI는 본질적으로 위험하니 통제해야 한다”는 식의 주장은 몽매주의(obscurantism·지식 확산을 막는 태도)에 가깝다. 과거 오스만 제국 군주들이 인쇄기 배포를 막았던 것과 비슷하다.”
Q : 월드모델은 뭐가 다른가.
A : “월드모델은 LLM과 달리 행동 결과를 예측할 수 있어 훨씬 똑똑해질 것이다. 목표 지향형 AI로 설계해서 통제하기 더 쉽다. AI가 똑똑하다고 통제할 수 없다는 생각은 틀렸다.”
오현우([email protected])