
[단독] 한강·황석영 책 도둑질, 화웨이 등 中 AI기업도 가세했다
중국 인공지능(AI) 스타트업 딥시크(DeepSeek) 로고. 로이터=연합뉴스
AI 업계의 최신 연구결과를 게시하는 사이트 아카이브(arXiv)를 보면, 중국 정보기술(IT) 기업이자 AI 기업인 화웨이는 자신의 AI 모델 ‘판구 시그마(Σ)’의 개발 기술보고서를 2023년 3월 공개했다. 모델의 구조와 학습 방법 등을 설명한 문서다. 화웨이는 이 보고서 AI 모델 학습을 위한 데이터를 어떻게 수집했는지를 설명해두고 있다. 구체적으로 영어 텍스트는 ‘더 파일(The Pile)’ 등을 썼다고 명시했다. 그 용량은 800Gb(기가바이트)에 달한다.
‘더 파일’은 AI 학습을 위해 책, 논문, 웹 문서 등을 모아 만든 데이터 셋(모음)이다. ‘더 파일’을 설명한 arXiv 문서를 보면, 여기엔 북스3(Books3) 데이터가 포함돼 있다. 북스3는 앤트로픽도 무단 다운로드를 한 ‘해적판’ 전자책 모음이다. ‘바츠 대 앤트로픽’ 소송에서 이 부분이 문제가 돼 앤트로픽은 저작권자들에게 책 1종당 3000달러(약 400만원)의 합의금을 지급하기로 했다.
깃허브(개발자들이 이용하는 플랫폼)에 공개돼 있는 북스3에 수록된 작품 목록을 보면, 한국 작가들의 영어 번역본 전자책은 최소 19종(작가 10명)이 포함돼 있다. 한강의 『소년이 온다』, 『채식주의자』를 비롯해 황석영의 『바리데기』, 신경숙의 『엄마를 부탁해』, 김영하 『나는 나를 파괴할 권리가 있다』 등이다. ‘더 파일’을 만든 제작자는 데이터셋 설명 문서에서 “긴 문맥을 모델링하는 연구와 일관된 이야기 구성에 매우 귀중하기 때문에” 디지털 도서를 ‘더 파일’에 넣었다고 설명했다.
지난 7월 17일 중국 상하이에서 열린 세계 인공지능(AI) 컨퍼런스(WAIC)에서 화웨이 로고. 로이터=연합뉴스
━
딥시크에선 『채식주의자』 19단어 그대로 나와
‘안나의 아카이브’는 해적 도서 사이트다. 이곳에도 한강·황석영·김영하 등 한국을 대표하는 작가의 영문 번역본 전자책이 올라와 있다. 김애란의 『비행운』 등은 중국어 번역본으로 있다. 딥시크가 모든 책을 내려받은 건 아니고, 학습을 위해 필요한 책만 받은 거여서 딥시크의 다운로드 목록에 한국 작가 책이 포함돼 있는지는 확인할 수 없다.
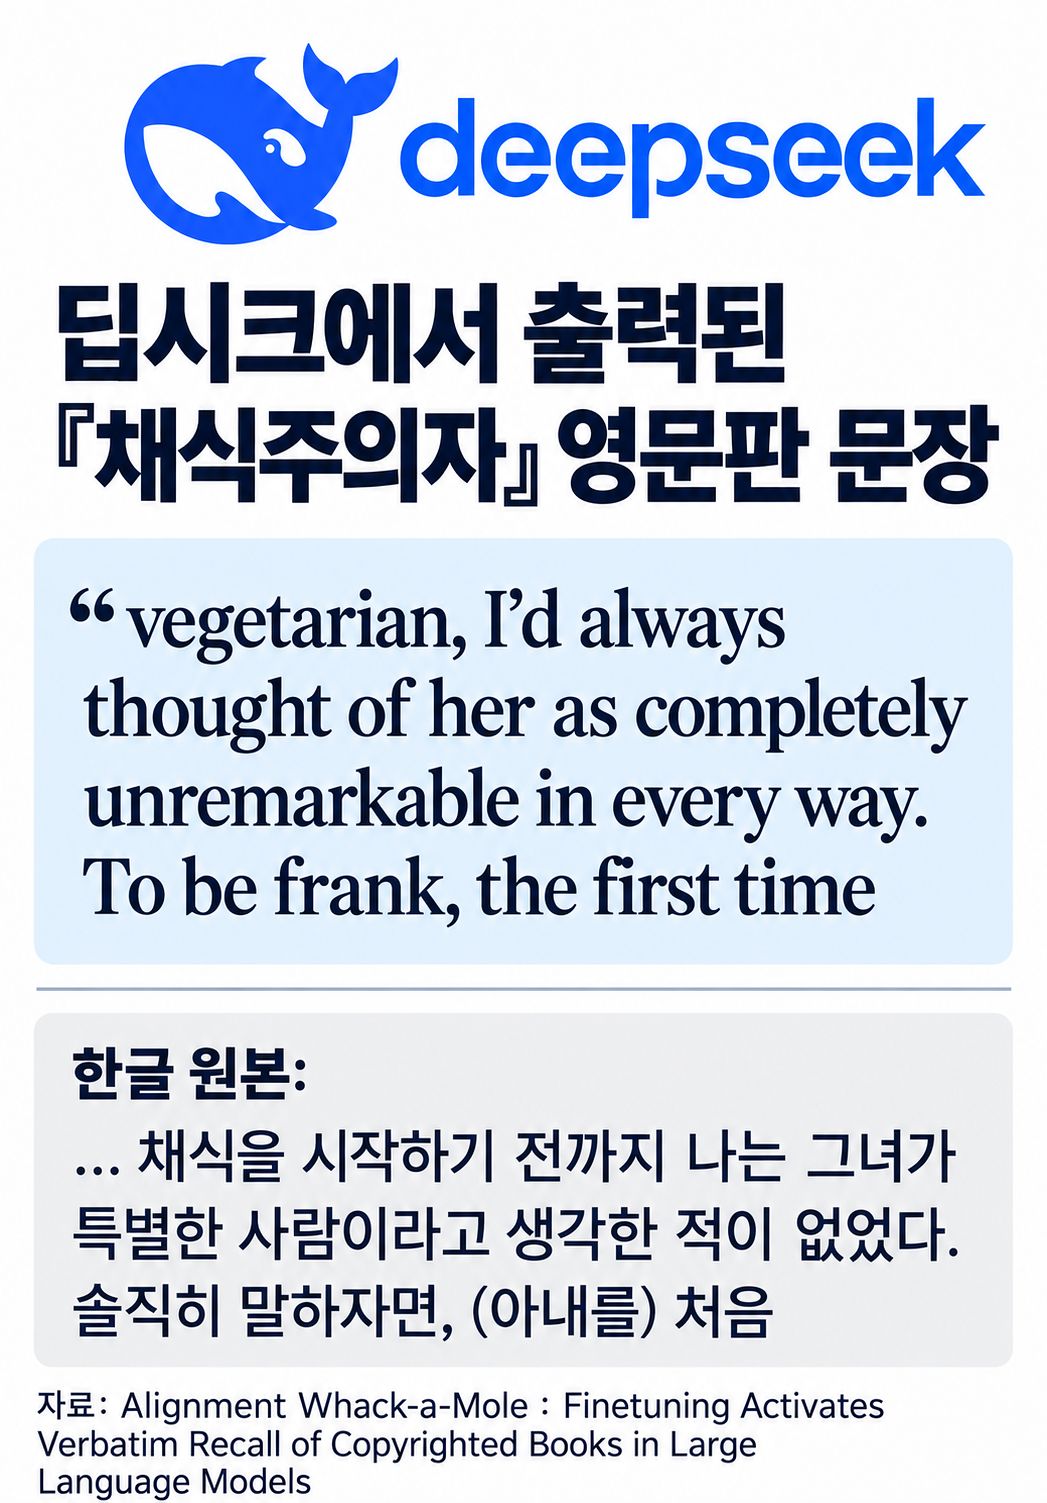
딥시크가 한국 작가 책을 학습시켰다는 간접 근거는 찾을 수 있다. 미국 컬럼비아대·카네기멜런대 등의 연구진이 지난 3월 처음 공개하고, 지난달 5번째 수정 버전을 공개한 논문을 보면 딥시크 3.1에서 ‘미세조정’이라는 과정을 거쳐 한강의 『채식주의자』 원문을 추출한 결과 연속 19단어가 원문과 똑같은 내용으로 출력됐다. 논문 저자들은 이를 AI 모델이 소설을 사전학습한 간접 증거로 봤다. 다만 이 논문은 심사 전 논문이라는 한계는 있다.
━
美·中만의 일 아냐…“AI 업계 관행”
“해적판 도서를 AI 학습 데이터로 쓴다는 건 AI 업계에선 많이 알려진 내용이다. AI모델 학습에 공개 데이터를 사용하는 것은 관행이었고, 그 안에는 해적판 도서도 포함되어 있는 경우가 존재했다. AI 업계가 모델 성능을 올리는 경쟁에 매몰되다 보니, 법적 문제를 깊이 고려하지 않고 저작권이 있는 데이터를 무작정 사용하던 시기가 있었다.”
AI 발전 초창기 땐 저작권이 있는 AI의 디지털 도서 학습이 세계적으로 광범위하게 이뤄졌다는 설명이다. 얼마나 관행이었는지, “해적판 도서를 포함하고 있는 공개 데이터셋을 논문에 학습 데이터 출처로 밝힐 정도였다”는 게 주 교수 설명이다. 그는 “최근 들어 점점 문제가 되면서 많은 빅테크 회사들이 학습 데이터를 비공개로 두는 경우가 많아지고 있다”고 덧붙였다.
윤성민([email protected])